[SW Arch] CQRS Architecture
CQRS 아키텍처
웹 서비스에서 ITO를 하다 보면 오랜 세월 여러 스펙을 거치며 엔티티들이 점점 뚱뚱해지는 경향이 있습니다.
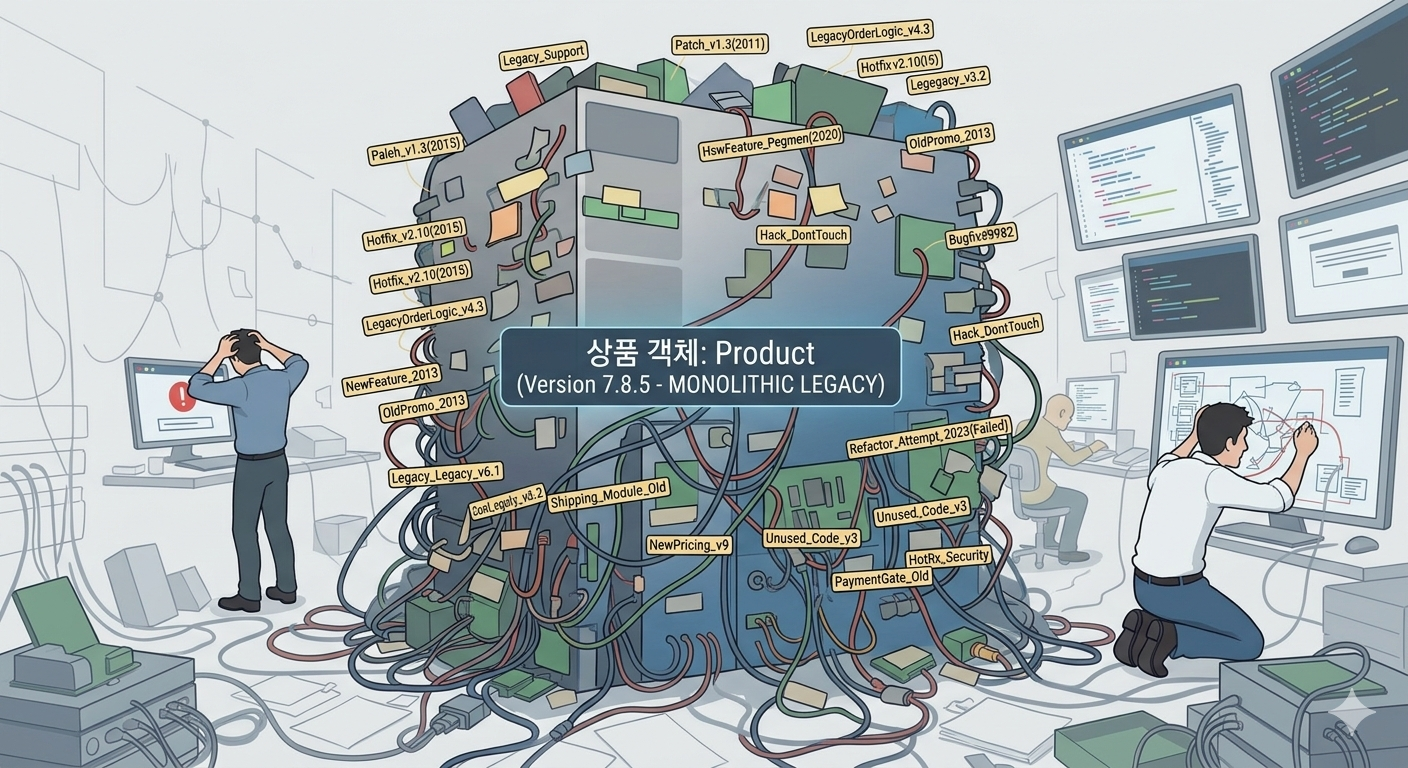 거대한 Prodcut 객체
사용자의 단순 조회에도 WAS를 거쳐 DB에서 상품, 리뷰, 포인트 테이블을 모두 JOIN해서 모든 필드가 채워진 거대한 객체를 반환하는 건 필연적으로 서비스가 느려지는 원인이 됩니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
{
  "productBean": {
    "name": "Phone X",
    "detailHtml": "<div>...(수십 KB)...</div>",
    "price": null,
    "subsidy": null,
    "colorList": null,
    "rentalType": null,
    "pgShopId": "XXXX",
    "couponLimit": "50000",
    "...": "필드 수백 개, 대부분 null"
  },
  "selectBean": { "planId": "P01", "supportType": "A", "...": null },
  "reviewCount": 10
}
// 무겁고 뚱뚱하다...
언제까지고 커지는 객체의 문제점을 개선하기 위해 나타난 패턴이 CQRS 패턴입니다.
CQRS 패턴이란?
CQRS 패턴은 1988년 Bertrand Meyer의 CQS에서 출발해 2010년 전후 Greg Young이 정리한 꽤 오래된 개념이지만, MSA와 DDD의 개념이 도입되는 요즘도 주로 채택되는 패턴입니다.
오히려 어느 정도 깊게 CQRS를 적용할지를 논의하는 게 요즘 트렌드입니다.
CQRS의 주 목적은 쓰기(Command)와 읽기(Query)의 책임을 분리하는 것입니다.
기존에는 쓰기와 읽기 모든 곳에 하나의 객체를 사용하다 보니 각각의 규칙, 연관관계, 표시용 필드가 덕지덕지 붙어 무거워질 수밖에 없습니다.
이를 쓰기와 읽기로 분리하면 아래처럼 각자의 역할에 맞게 집중할 수 있습니다.
- 쓰기 모델: 상태를 바꾸는 쪽으로, 실제 데이터를 변경하기에 규칙과 상태에 집중합니다.
- 읽기 모델: 데이터를 보여주는 쪽으로, 화면에 맞는 모양과 조회 성능에 집중합니다.
예시
아래와 같이 무거운 객체가 있다고 가정합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public class Product {
    // 상품 정보
    private String id;
    private String name;
    private long price;

    // 화면 표시용
    private String imageUrl;
    private int reviewCount;
    private double rating;

    // 주문·결제용
    private String pgShopId;
    private long couponLimit;
    private int stock;

    // ... 디컴된 로직에 있던 수없이 많은 필드

    // 상태 변경 로직
    public void changePrice(long newPrice) { ... }
    public void decreaseStock(int qty) { ... }
}
이를 CQRS를 적용하여 다이어트(쓰기 모델과 읽기 모델) 시켜 보겠습니다.
쓰기 모델
기존 객체에서 읽기 관련 필드가 빠지면서 기존 객체 또한 더 가벼워질 수 있습니다.
아래는 기존 모델에서 더 가벼워진 쓰기 모델입니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
@Entity
public class Product {
    @Id
    private String id;
    private String name;
    private long price;
    private int stock;

    public void changePrice(long newPrice) {
        if (newPrice <= 0) throw new IllegalArgumentException();
        this.price = newPrice;
    }

    public void decreaseStock(int qty) {
        if (stock < qty) throw new IllegalStateException("재고 부족");
        this.stock -= qty;
    }
}

@Entity
public class PaymentPolicy {      // 주문 시에만 필요한 값은 따로
    @Id
    private String productId;
    private String pgShopId;
    private long couponLimit;
}
읽기 모델
단순 조회 시에는 훨씬 더 가벼운 객체를 사용할 수 있습니다.
1
2
3
4
5
6
7
8
9
public record ProductDetailView(
    String id,
    String name,
    long price,
    String imageUrl,
    int reviewCount,
    double rating,
    boolean inStock
) {}
다만 단순히 객체가 가벼워졌다는 것이 아닌 무거운 엔티티를 거치지 않는다는 포인트가 있습니다.
기존 조회
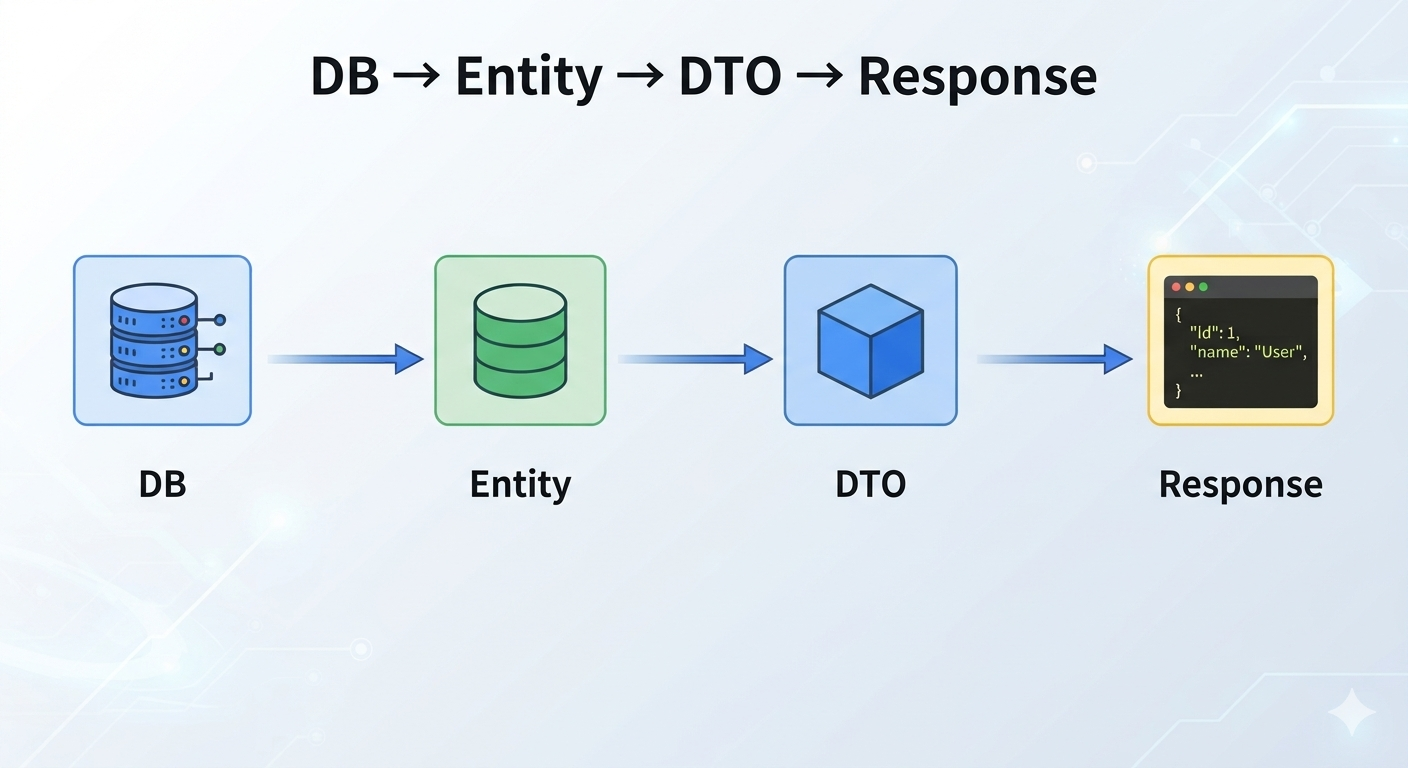
이 조합에서는 무거운 객체를 채우기 위해 DB단에서 JOIN 등의 작업이 필요하여 필연적으로 지연이 발생했습니다.
CQRS 조회
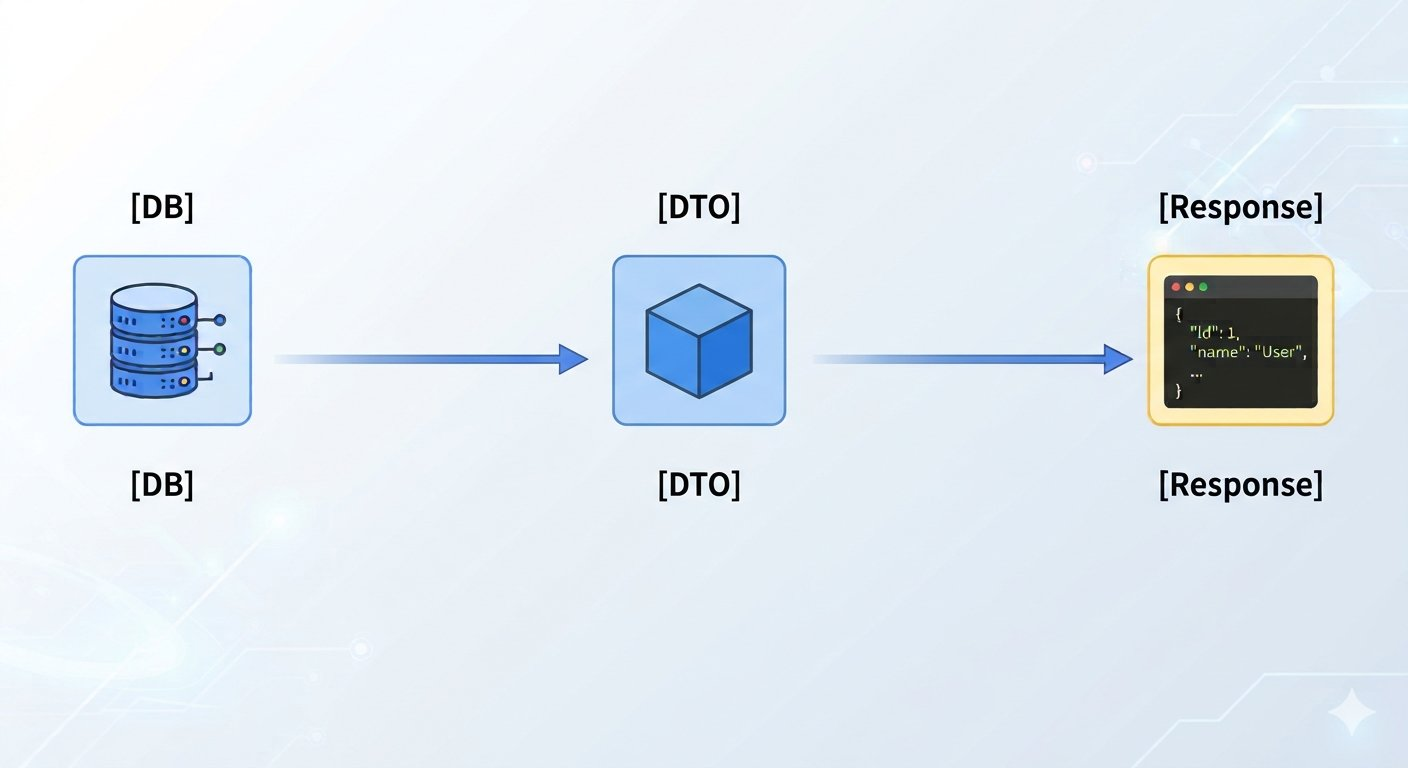
읽기 전용에선 불필요한 JOIN을 피할 수 있습니다. 읽기에 필요한 정보만 조회 전용 모델(View)을 통해 엔티티를 거치지 않고 바로 응답하도록 개선 가능합니다.
읽기 전용 DB
Read만 하는 흐름에서 CQRS를 더 개선할 수 있는 포인트가 하나 더 있습니다.
본래 DB와 분리된, 읽기 작업에만 집중된 별도의 저장소를 두는 방법입니다.
예를 들어 Redis를 사용할 수 있습니다.
다만 실제 RDB에 데이터 변경이 이뤄지면 그 변경 사항이 Redis에도 전파될 필요가 있습니다.
이를 정리하면 아래와 같이 흘러갈 수 있습니다.
CQRS 적용 패턴 흐름
- 쓰기 전용 엔티티를 통해 데이터가 실제 RDB에 변경됩니다.
- 이를 Redis에 전파합니다.
- 이후 읽기 요청에 대해서는 Redis에서 즉시 응답합니다.
다만 이 과정에서 RDB의 변경 사항이 Redis에 전파되지 않을 수 있습니다. 이를 방지하기 위해 Outbox 패턴 등으로 유실을 막고, 재전송으로 인한 중복 반영에 대비한 멱등성 처리가 필요합니다.
CQRS 트레이드 오프
기존의 무거운 객체를 목적에 따라 경량화하고, 객체뿐만 아니라 데이터의 응답 방식, 더 나아가 읽기 전용 별도의 저장소까지 구축하여 조회 성능을 높일 수 있습니다. 또한 쓰기 전용을 분리함으로써 부하를 줄이고, 독립된 엔티티로 유지보수에도 큰 이점을 가지게 됩니다.
다만 저장소 분리로 인해 일관성 문제는 항상 신경 써야 합니다.
방금 수정/추가했는데 실제 고객 화면에는 이전 값이 보이는 상황이 발생할 수 있으며, 결제, 재고 같은 경우는 원본에서 다시 확인하는 로직이 필요합니다. 또한 동기화 실패 후 재시도에 대비한 멱등성 처리도 고려할 필요가 있습니다.
또한 모델이 둘이기에 복잡도가 증가할 수 있어, 단순 CRUD가 아닌 복잡한 조회 또는 읽기 트래픽이 큰 조회성 서비스에 적절한 패턴이라고 볼 수 있습니다.
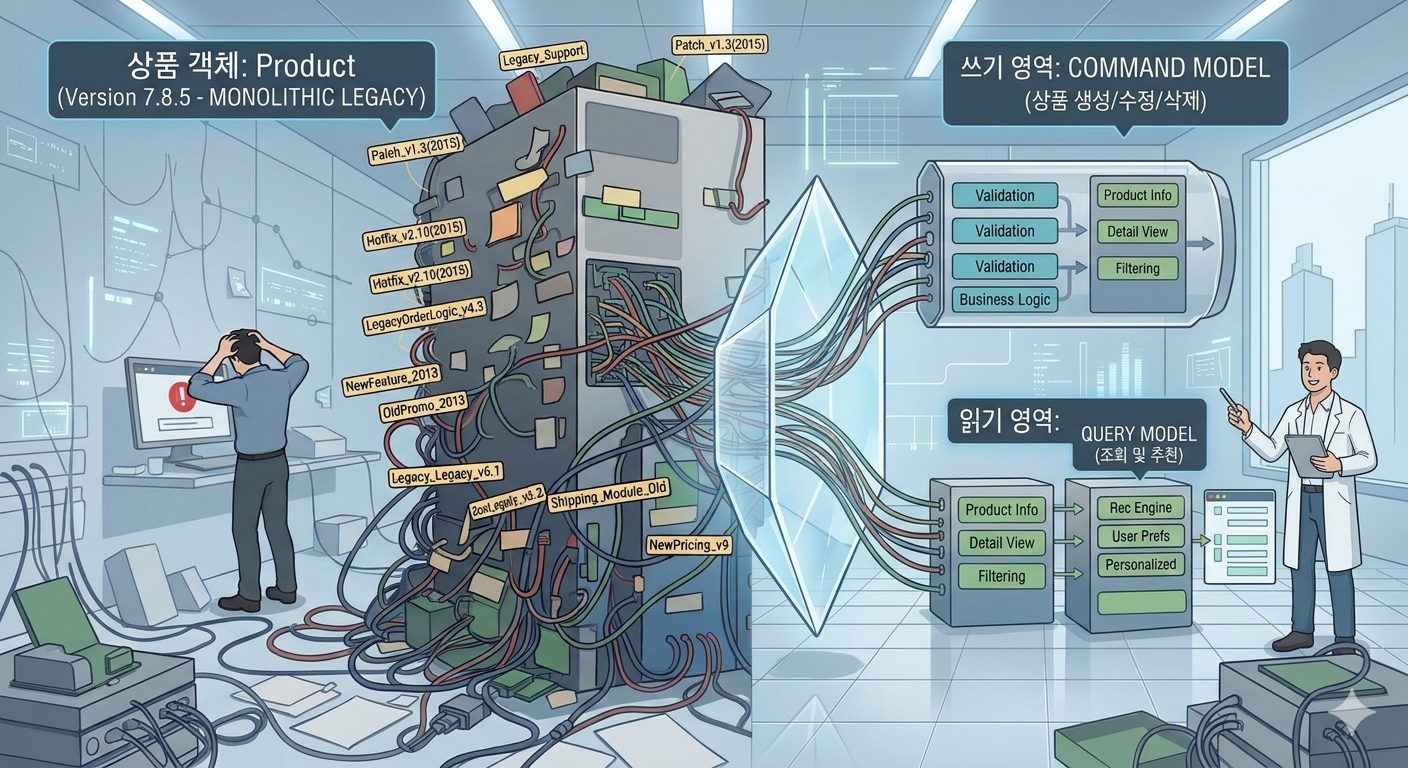 다이어트 성공